



Plus de la moitié des organisations interrogées par l’Uptime Institute déclarent que leur dernière panne significative leur a coûté plus de 100 000 dollars, et une sur cinq plus d’un million. Dans la plupart des cas, l’incident a commencé par un signal faible que personne n’a vu passer : un disque qui se remplit, un temps de réponse qui dérive, un certificat qui approche de son expiration.
La supervision informatique sert à capter ces signaux avant qu’ils ne deviennent des pannes. Cet article en donne la définition, les objectifs et les grands types, détaille son fonctionnement et les outils du marché, puis aborde la question que les éditeurs traitent rarement : qui surveille, et à quelle heure. Il porte sur la supervision des systèmes d’information, et non sur la supervision industrielle des automates de production.
Qu’est-ce que la supervision informatique ?
Définition
La supervision informatique, ou supervision IT, désigne l’ensemble des outils et des pratiques qui permettent de surveiller en continu l’état d’un système d’information : serveurs, réseau, bases de données, applications et services cloud. Elle collecte des mesures, les compare à des seuils, alerte en cas d’anomalie et fournit une vue d’ensemble de la santé du SI.
Son but n’est pas de produire des graphiques, mais de raccourcir le délai entre l’apparition d’un problème et sa résolution. Une supervision efficace détecte un incident avant les utilisateurs, aide à en trouver la cause et garde la trace de ce qui s’est passé.
Supervision, monitoring, observabilité, hypervision : les nuances
Ces termes se recoupent et sont souvent employés l’un pour l’autre. Le monitoring désigne la mesure et la surveillance d’indicateurs, la brique technique de base. La supervision y ajoute la dimension opérationnelle : le traitement des alertes, l’escalade et le pilotage des incidents.
L’observabilité va plus loin dans l’analyse : elle croise métriques, logs et traces pour comprendre le comportement d’un système, y compris face à un problème imprévu. L’hypervision, enfin, consolide plusieurs outils de supervision dans une console unique, utile quand un SI en accumule plusieurs au fil des années.
Les objectifs de la supervision informatique
Une supervision bien conçue répond à des objectifs métier, pas seulement techniques. On peut les regrouper en six familles.
- Garantir la disponibilité des services dont dépendent vos équipes et vos clients, en détectant les pannes au plus tôt.
- Maintenir la performance : repérer les ralentissements avant qu’ils ne deviennent perceptibles ou bloquants.
- Anticiper les saturations : espace disque, mémoire, bande passante, licences. La plupart des pannes de capacité sont prévisibles des semaines à l’avance.
- Détecter les menaces : comportements anormaux, tentatives d’intrusion, modifications non autorisées.
- Piloter les engagements de service : mesurer la disponibilité réelle, suivre les délais de résolution et rendre compte aux directions métier.
- Optimiser les coûts : identifier les ressources surdimensionnées ou inutilisées, notamment dans le cloud.
Le premier objectif est le plus visible, mais c’est souvent l’anticipation qui rapporte le plus : un incident évité ne coûte rien, ni en heures d’intervention ni en image.
Les types de supervision informatique
La supervision de l’infrastructure
C’est le socle : serveurs physiques et virtuels, stockage, hyperviseurs, conteneurs et ressources cloud. On y surveille la charge processeur, la mémoire, l’espace disque, l’état des services système et des sauvegardes.
Dans un environnement hybride, la difficulté est d’obtenir une vue unique entre serveurs sur site et services cloud, qui exposent leurs mesures de façons très différentes.
La supervision réseau
Elle couvre les équipements (routeurs, commutateurs, pare-feux, bornes Wi-Fi) et les liens : disponibilité, débit, latence, perte de paquets. Elle s’appuie notamment sur le protocole SNMP, présent sur la quasi-totalité des équipements réseau.
C’est la supervision réseau qui permet de distinguer un serveur en panne d’un serveur simplement injoignable, une nuance qui change complètement le diagnostic.
La supervision applicative
Elle mesure ce que vivent réellement les utilisateurs : temps de réponse des applications, taux d’erreurs, disponibilité des parcours clés, performance des requêtes en base de données. Elle passe par des outils d’APM (Application Performance Monitoring) et par des tests synthétiques qui simulent des parcours utilisateurs.
Une infrastructure entièrement au vert n’empêche pas une application d’être inutilisable. C’est pourquoi la supervision applicative est indispensable dès qu’une application porte du chiffre d’affaires ou un processus critique, avec, si besoin, un audit de performance applicative pour en identifier les points faibles.
La supervision de la sécurité
Elle surveille les événements de sécurité : connexions suspectes, élévations de privilèges, flux réseau inhabituels, alertes des antivirus et des pare-feux. Elle repose sur un SIEM, qui centralise et corrèle ces événements, et sur une équipe d’analystes, le SOC.
Supervision de performance et supervision de sécurité partagent des outils de collecte, mais pas les mêmes compétences ni les mêmes délais de réaction. La seconde relève d’un SOC managé dès que l’entreprise n’a pas les ressources pour assurer une veille permanente.
La supervision métier
C’est la plus proche des directions générales : elle suit des indicateurs d’activité (commandes passées, factures émises, flux échangés avec les partenaires) et alerte quand ils s’écartent de la normale.
Une chute brutale du nombre de commandes peut révéler une panne qu’aucune sonde technique n’a vue, comme un module de paiement qui refuse silencieusement les cartes. La supervision métier fait le lien entre l’état du SI et ses conséquences concrètes.
| Type | Ce qui est surveillé | Question à laquelle elle répond |
|---|---|---|
| Infrastructure | Serveurs, stockage, virtualisation, cloud | Les ressources tiennent-elles ? |
| Réseau | Équipements, liens, débit, latence | Les flux circulent-ils ? |
| Applicative | Temps de réponse, erreurs, parcours | Les utilisateurs peuvent-ils travailler ? |
| Sécurité | Événements, accès, comportements anormaux | Le SI est-il attaqué ? |
| Métier | Indicateurs d’activité | L’activité se déroule-t-elle normalement ? |
Votre SI est-il supervisé de bout en bout ?
Nous cadrons la supervision de vos infrastructures et de vos applications, et assurons l'exploitation des alertes des heures ouvrées jusqu'à l'astreinte 24/7.
Comment fonctionne la supervision, de la collecte à l’action
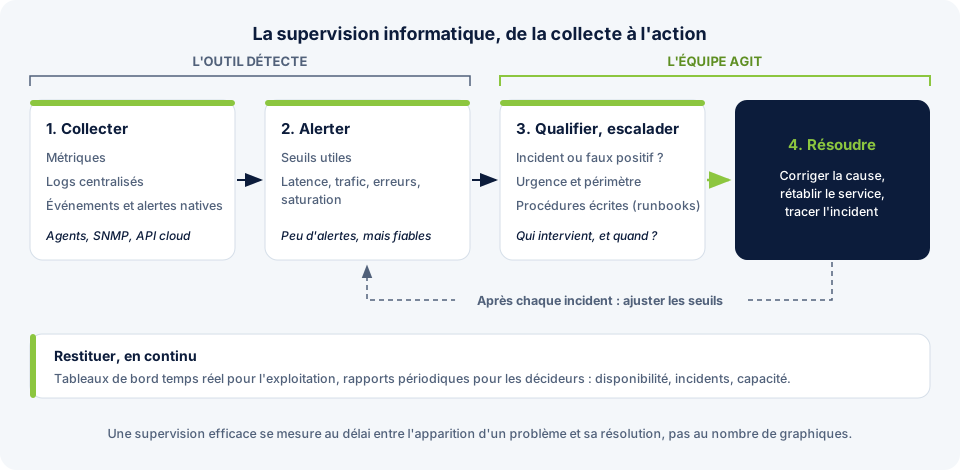
Collecter les métriques, les logs et les événements
Tout commence par la collecte. Des agents installés sur les serveurs, des requêtes SNMP vers les équipements réseau ou des appels aux API des services cloud remontent en continu des métriques (valeurs chiffrées), des logs (journaux d’événements) et des alertes natives.
Les logs méritent une attention particulière : ce sont eux qui expliquent un incident une fois qu’il est détecté. Les centraliser dans une plateforme unique, par exemple avec une stack ELK, fait passer un diagnostic de plusieurs heures à quelques minutes.
Définir des seuils et des alertes utiles
Une alerte doit appeler une action. Les ingénieurs de Google ont formalisé dans leur ouvrage de référence sur le SRE quatre signaux clés à surveiller pour tout service : la latence, le trafic, les erreurs et la saturation. C’est un bon point de départ pour éviter de tout surveiller sans rien voir.
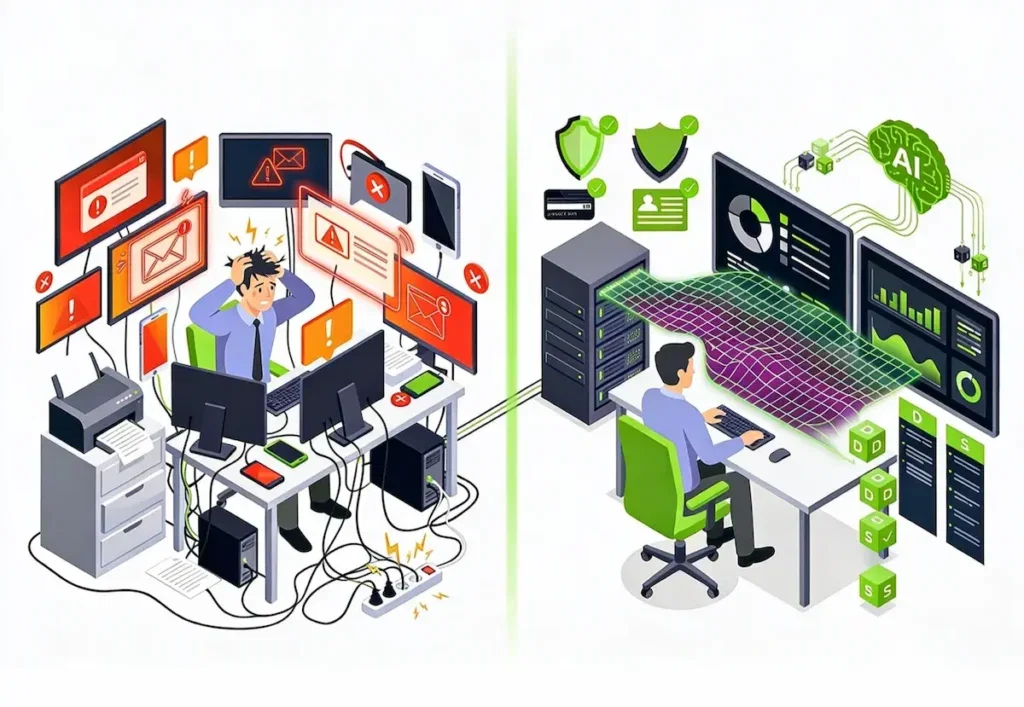
Le principal ennemi de la supervision est la fatigue d’alerte. Quand une équipe reçoit des centaines de notifications par jour, elle cesse de les lire, et l’alerte importante passe inaperçue. Mieux vaut dix alertes fiables que mille alertes bruyantes.
Qualifier, escalader et résoudre
Une fois l’alerte déclenchée, il faut la qualifier (incident réel ou faux positif, urgence, périmètre touché), la router vers la bonne personne et suivre sa résolution, généralement dans un outil de ticketing. Des procédures écrites à l’avance, les runbooks, précisent pour chaque type d’alerte les vérifications et les actions autorisées.
C’est à cette étape que se joue l’essentiel de l’efficacité. Une supervision qui détecte en une minute un incident traité trois heures plus tard n’a pas rempli son rôle.
Restituer l’état du système d’information
Enfin, la supervision produit des tableaux de bord en temps réel pour les équipes d’exploitation et des rapports périodiques pour les décideurs : disponibilité mesurée, incidents du mois, tendances de capacité. Ces rapports nourrissent les arbitrages d’investissement et le suivi des engagements contractuels.
Les outils de supervision informatique
Le marché se partage entre solutions open source, éditeurs historiques et plateformes SaaS. Aucune n’est meilleure dans l’absolu : le bon logiciel de supervision est celui que vos équipes sauront exploiter.
| Catégorie | Exemples | Points forts | Points d’attention |
|---|---|---|---|
| Open source | Zabbix, Centreon, Nagios, Prometheus et Grafana | Pas de licence, grande souplesse, données hébergées chez vous | Installation, maintenance et montée de version à votre charge |
| Plateformes SaaS | Datadog, Dynatrace, New Relic | Mise en route rapide, APM et cloud natifs, fonctions d’IA | Coût qui grimpe avec le volume, données hébergées chez l’éditeur |
| Logs et sécurité | Splunk, Elastic (ELK), Microsoft Sentinel | Analyse et corrélation de grands volumes d’événements | Expertise nécessaire pour en tirer de la valeur |
Trois critères pèsent plus que la liste des fonctionnalités : la couverture de votre environnement réel (sur site, cloud, hybride), la capacité à réduire le bruit des alertes et le coût total sur trois ans, temps d’exploitation compris.
Mettre en place la supervision de votre SI en 5 étapes
Un projet de supervision échoue rarement sur l’outil. Il échoue quand on installe d’abord et qu’on réfléchit ensuite. La démarche inverse tient en cinq étapes.
- Cartographier les services critiques. Partir des services métier (prise de commande, paie, messagerie) et remonter vers les applications, serveurs et liens dont ils dépendent.
- Définir les indicateurs et les seuils. Pour chaque service, ce qui doit être mesuré, à partir de quelle valeur on alerte, et avec quelle urgence.
- Choisir et déployer l’outillage. Seulement à ce stade, en fonction de l’environnement, des compétences internes et du budget.
- Organiser la réponse. Qui reçoit les alertes, sur quelle plage horaire, avec quelles procédures et quels délais d’intervention.
- Améliorer en continu. Revoir les seuils après chaque incident, supprimer les alertes inutiles, ajouter celles qui ont manqué.
L’étape 4 est la plus souvent négligée. C’est pourtant elle qui détermine si une alerte à 2 heures du matin sera traitée à 2 h 10 ou à 9 heures.
Supervision et IA : ce que change l’AIOps
Les volumes de données produits par un SI moderne dépassent ce qu’une équipe peut analyser à la main. L’AIOps applique l’intelligence artificielle à l’exploitation : détection d’anomalies sans seuil fixe, corrélation automatique d’alertes liées à une même cause, prévision des saturations, voire déclenchement d’actions correctives.
L’apport est réel sur la réduction du bruit et l’anticipation. Mais l’AIOps ne remplace ni une collecte propre ni une organisation claire : elle amplifie la qualité de la supervision existante, dans un sens comme dans l’autre. Nous détaillons ces usages dans notre article sur l’AIOps.
Superviser en interne ou externaliser ?
Assurer une supervision informatique en interne suppose des outils, des compétences et surtout une présence. Couvrir les nuits, les week-ends et les congés avec une astreinte demande une équipe suffisamment nombreuse pour tourner, ce que peu d’ETI et de PME peuvent mobiliser.
Trois modèles coexistent. La supervision seule : un prestataire surveille et alerte, vos équipes traitent. L’infogérance : le prestataire prend en charge l’exploitation complète avec des engagements contractuels. La régie : des experts renforcent votre équipe, sous votre pilotage. Le bon modèle dépend de ce que vous voulez déléguer : la surveillance, ou la responsabilité du résultat.
Superviser votre SI avec Castelis
La supervision informatique n’apporte de valeur que si elle est reliée à vos services métier et suivie d’une action. C’est précisément là que Castelis intervient : nous cadrons ce qui doit être supervisé, déployons l’outillage adapté à votre environnement et exploitons les alertes dans la durée.
Dans le cadre de notre infogérance cloud et on-premise, nous assurons la supervision de vos serveurs, réseaux, sauvegardes et applications, avec une couverture calibrée sur la criticité de chaque environnement : heures ouvrées, plages étendues ou astreinte 24/7. Le volet sécurité est porté par notre SOC, qui surveille et répond aux incidents en continu.
Plus de 25 ans d’expérience, plus de 500 projets livrés et une certification ISO 27001 : nous travaillons avec les outils du marché (Centreon, New Relic, Splunk, Kibana) en fonction de votre architecture, avec des engagements de service mesurables et un reporting lisible par vos directions métier.
Confiez la supervision de votre SI à une équipe qui répond
Cadrage, déploiement de la supervision et exploitation des alertes jusqu'au 24/7, avec des SLA définis dès le départ.
FAQ
C’est quoi la supervision informatique ?
La supervision informatique est l’ensemble des outils et des pratiques qui surveillent en continu un système d’information (serveurs, réseau, applications, services cloud) pour détecter les anomalies, alerter les équipes et accélérer la résolution des incidents. Elle vise à garantir la disponibilité et la performance des services dont dépend l’activité de l’entreprise.
Quels sont les trois types de supervision ?
Les trois types de supervision informatique les plus couramment cités sont la supervision système (ou d’infrastructure), qui surveille les serveurs et le stockage, la supervision réseau, qui surveille les équipements et les liens, et la supervision applicative, qui mesure le fonctionnement des applications du point de vue des utilisateurs. On y ajoute souvent la supervision de sécurité et la supervision métier.
Quel est le meilleur outil de supervision informatique ?
Il n’existe pas de meilleur outil universel. Zabbix et Centreon sont des références open source, appréciées pour leur souplesse et l’absence de licence. Datadog, Dynatrace ou New Relic sont des plateformes SaaS rapides à déployer et fortes sur l’APM et le cloud. Le bon choix dépend de votre environnement, de vos compétences internes et du coût total d’exploitation, pas seulement des fonctionnalités.
Qu’est-ce qu’un superviseur informatique ?
Le superviseur informatique, aussi appelé technicien ou pilote d’exploitation, surveille en continu l’état du système d’information depuis les consoles de supervision. Il qualifie les alertes, applique les premières procédures de résolution, escalade vers les équipes spécialisées et suit les incidents jusqu’à leur clôture. Il travaille souvent en horaires décalés pour assurer une couverture étendue.
Quelle est la différence entre supervision et monitoring ?
Le monitoring désigne la collecte et la surveillance d’indicateurs techniques : il mesure et alerte. La supervision englobe le monitoring et y ajoute la dimension opérationnelle : la qualification des alertes, l’escalade, le traitement des incidents et le pilotage global de la santé du SI. Dans l’usage courant, les deux termes sont toutefois souvent employés comme synonymes.
Comment mettre en place un projet de supervision informatique ?
En partant des services métier plutôt que de l’outil. On cartographie d’abord les services critiques et leurs dépendances, on définit les indicateurs et les seuils d’alerte, puis on choisit l’outillage. On organise ensuite la réponse aux alertes (qui, quand, avec quelles procédures) et on ajuste le dispositif après chaque incident. Cette dernière étape fait la différence entre une supervision qui vit et une supervision qui s’encrasse.
 Équipe Castelis
 7 min
 05 Mai 2026